En esta página
Puntos clave
- Mitigar no bastaSi el tráfico limpio no vuelve bien, la cadena sigue incompleta.
- El handoff define la realidad operativaLatencia, MTU, routing y monitorización se vuelven temas centrales.
- Hay varios modelos creíblesGRE, BGP over GRE, IP protegidas, cross-connect o router VM según la necesidad.
Por qué la entrega de tráfico limpio importa tanto como la mitigación
Si la capa de limpieza detiene el ataque pero devuelve mal el tráfico limpio, el cliente sigue teniendo un problema de producción. El resultado real no es “el ataque fue visto”, sino “el servicio siguió disponible y utilizable”.
La entrega limpia convierte una capacidad teórica en un resultado operativo. Esa es la diferencia entre una plataforma bonita en slides y una arquitectura que sobrevive en producción.
- Resultado de negocio
- El tráfico legítimo debe volver al servicio que lo consume.
- Resultado de red
- El handoff debe ser coherente con el routing y las restricciones existentes.
- Resultado operativo
- El equipo debe entender qué entra, qué sale y cómo monitorizarlo.
Principales modelos de entrega de tráfico limpio
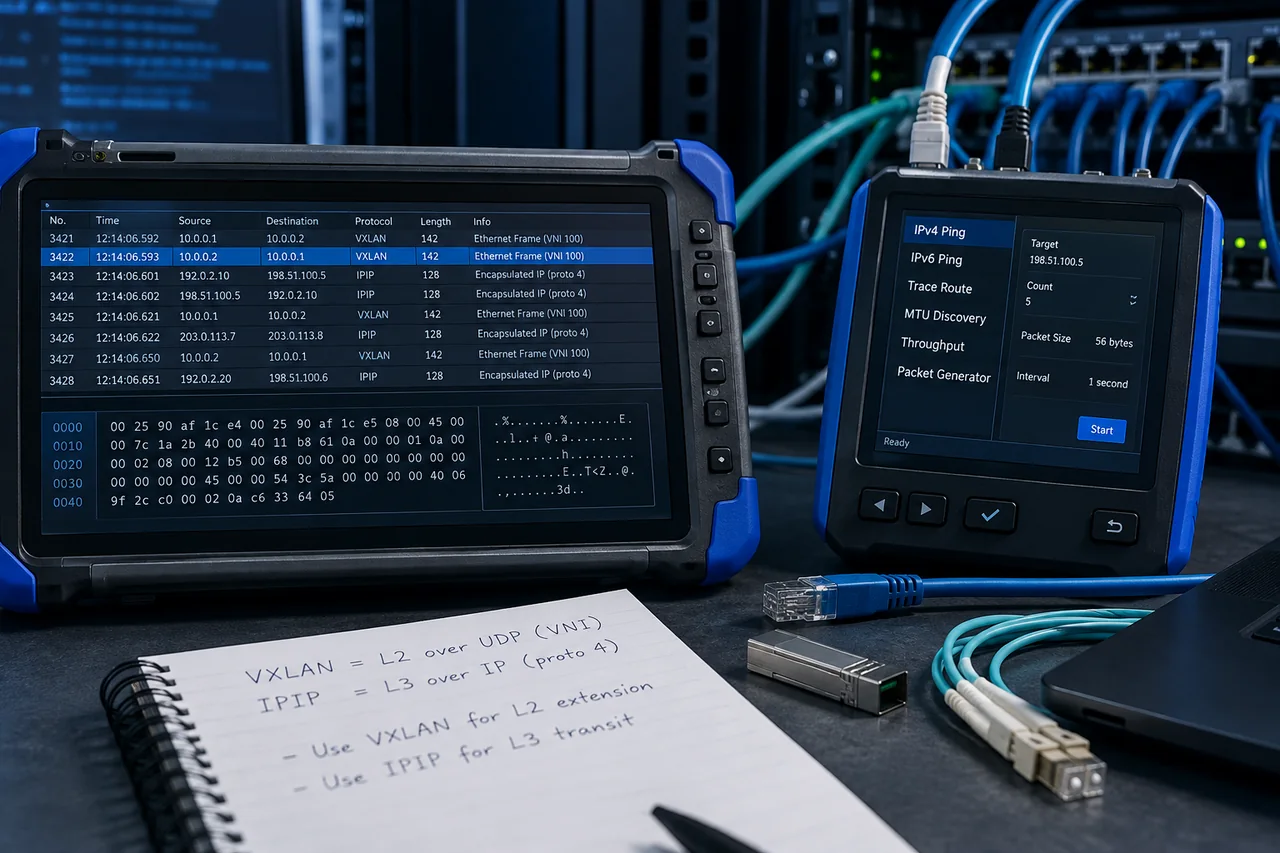
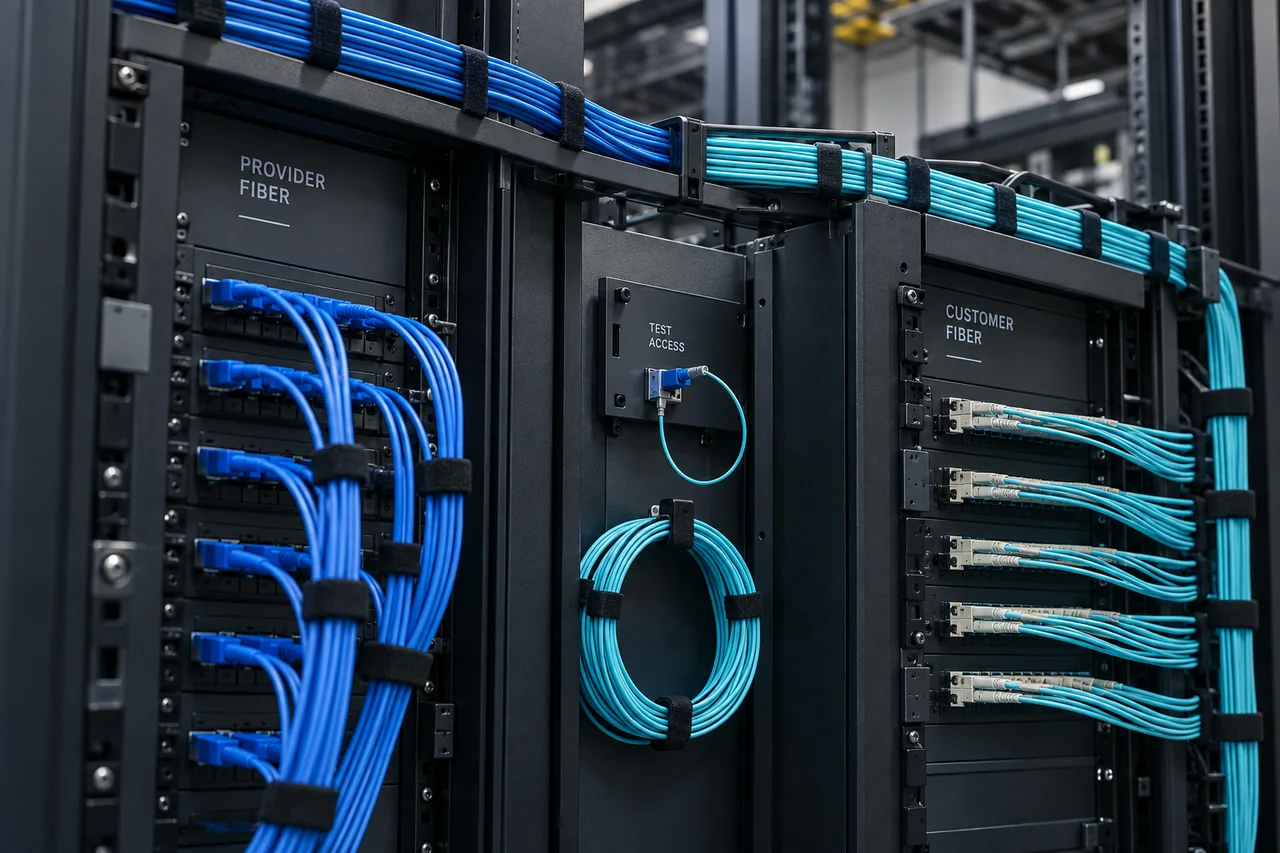
No existe un único modelo universal. Según el nivel de control necesario, el tráfico limpio puede volver por GRE, IPIP, VXLAN, BGP over GRE, cross-connect o una router VM entre la mitigación y el entorno del cliente.
La elección correcta depende sobre todo del direccionamiento público, del control BGP, de la velocidad de despliegue y de cuánto quiera preservarse la arquitectura existente.
GRE simple
Rápido de desplegar y a menudo suficiente para empezar de forma limpia.
BGP over GRE
Aporta más control cuando los prefijos y el routing deben seguir en el lado del cliente.
IP protegidas / cross-connect / router VM
Útil según el nivel de simplificación o control esperado.
Latencia, MTU y routing asimétrico: lo que el handoff cambia de verdad
El modelo de entrega impacta directamente la latencia percibida, el MTU disponible, el comportamiento del routing asimétrico y la facilidad de troubleshooting. Los compradores técnicos miran esto muy de cerca, sobre todo en gaming, APIs o servicios críticos.
Por eso un modelo creíble debe diseñarse desde el inicio alrededor de las restricciones de producción: dónde vuelve el tráfico, cómo sale de nuevo, qué MTU queda cómodo y cómo evitar sorpresas cuando llega el ataque.
Por qué preservar el entorno existente suele ser la mejor estrategia
En muchos casos el cliente no quiere reinventar la red. Quiere añadir una capa Anti-DDoS limpia delante de un dedicado existente, un clúster, un proxy de negocio o una lógica custom que ya aporta valor.
Permite añadir protección sin convertir la integración en un proyecto de migración pesado.
- Conservar un servidor actual en OVH, Hetzner u otro proveedor
- Conservar una lógica XDP, DPDK o proxy ya en producción
- Añadir una capa de limpieza sin mover toda la arquitectura
- Ganar madurez de forma progresiva en lugar de cambiarlo todo de golpe
Errores frecuentes
El primer error es infravalorar la entrega y centrarse solo en el scrubbing. El segundo es escoger un modelo de retorno más complejo de lo necesario cuando uno más simple habría sido más robusto.
Otro error común es ignorar MTU, monitorización y retorno asimétrico hasta el peor momento posible: el ataque mismo.
- Apostarlo todo a la mitigación
- La limpieza sola no garantiza que el servicio quede realmente restaurado.
- Elegir por reflejo el modelo más “premium”
- El handoff correcto es el que encaja con la arquitectura del cliente.
- Ignorar detalles de red
- MTU, retorno, routing y monitoring nunca son detalles menores en una crisis.
FAQ
¿Puede volver el tráfico limpio a mi servidor actual?
Sí. En muchos casos ese es exactamente el objetivo del diseño.
¿GRE simple suele bastar?
Sí. Para muchos despliegues, GRE simple ya es un compromiso muy fuerte.
¿Cuándo debe añadirse BGP?
Principalmente cuando quiere conservar más control sobre sus prefijos y decisiones de routing.
¿Importa el handoff tanto como la capacidad anunciada?
Sí. Sin una entrega limpia, la capacidad por sí sola no crea el resultado esperado en producción.
¿Por qué la entrega de tráfico limpio suele ser el punto débil real?
Porque muchos proyectos piensan primero en el scrubbing y luego improvisan la entrega. Una mala devolución del tráfico limpio rompe latencia, sesiones y operación.