Sur cette page
À retenir
- Le trafic propre est une question de design, pas seulement de filtrageUne mitigation crédible protège le lien puis redonne un trafic exploitable à la bonne cible, avec un handoff cohérent et durable.
- Le handoff détermine la réalité d’exploitationLatence, MTU, routage et supervision deviennent des sujets centraux.
- Plusieurs modèles sont crédiblesGRE, BGP over GRE, IP protégées, cross-connect ou VM routeur selon le besoin.
Pourquoi le retour du trafic compte autant que la mitigation
Si la couche de nettoyage stoppe l’attaque mais que le trafic propre est mal remis, le client garde malgré tout un problème de production. Le vrai résultat attendu n’est pas “l’attaque a été vue”, mais “le service est resté joignable et exploitable”.
Le retour propre du trafic transforme une capacité théorique en résultat opérationnel. C’est ce qui fait la différence entre une plateforme qui impressionne dans les slides et une architecture qui tient en exploitation.
- Résultat métier
- Le trafic légitime doit vraiment revenir au service qui le consomme.
- Résultat réseau
- Le handoff doit rester cohérent avec le routage et les contraintes existantes.
- Résultat opérationnel
- L’équipe doit comprendre ce qui entre, ce qui sort et comment le suivre.
Les grands modèles de relivraison du trafic propre
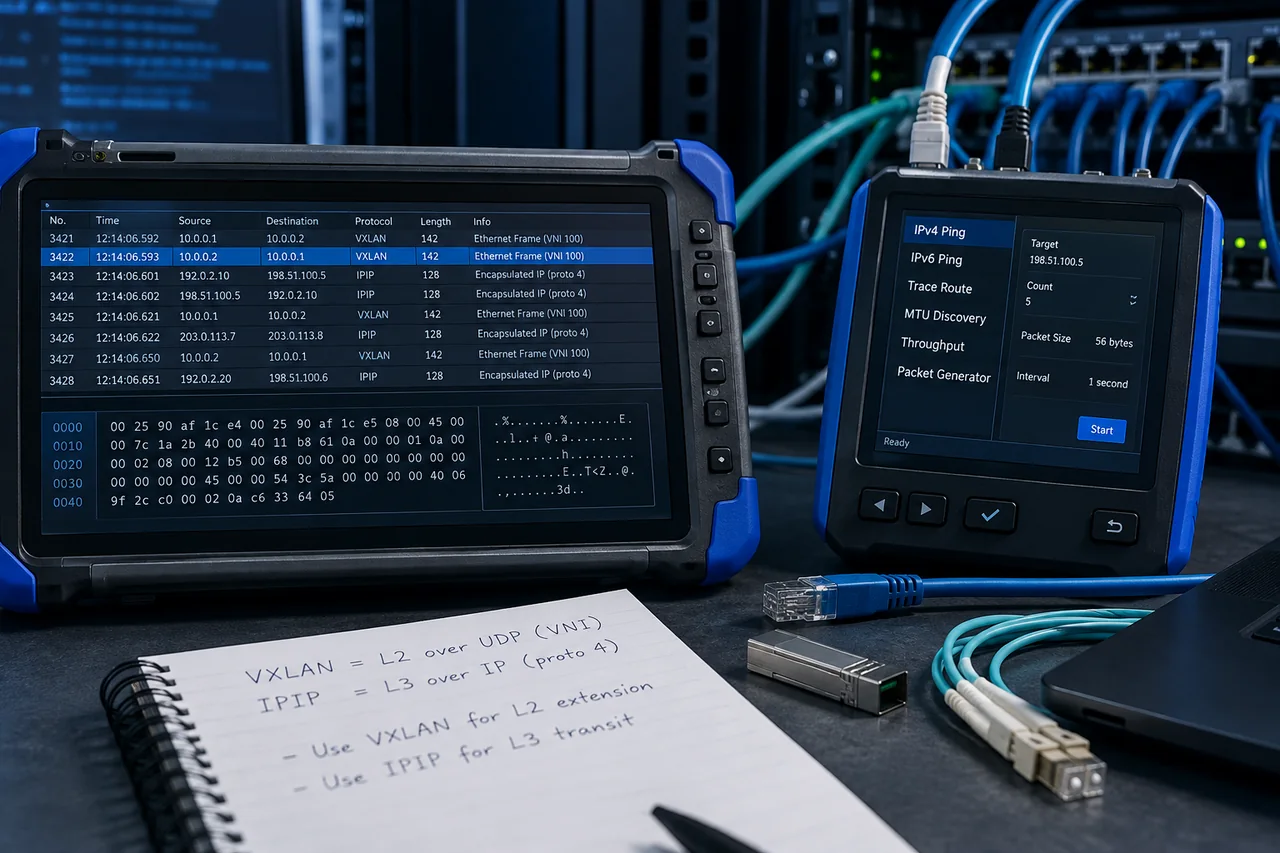
Il n’existe pas un seul bon modèle universel. Selon le niveau de contrôle voulu, on peut renvoyer le trafic propre par GRE, IPIP, VXLAN, BGP over GRE, cross-connect ou encore via une VM routeur qui sert d’interface entre la mitigation et l’infrastructure cliente.
Le bon choix dépend surtout de l’adressage public, du niveau de maîtrise BGP, de la vitesse de déploiement recherchée et du fait que l’on veuille ou non conserver au maximum l’architecture déjà en place.
GRE simple
Rapide à déployer et souvent suffisant pour démarrer proprement.
BGP over GRE
Apporte plus de contrôle quand les préfixes et le routage doivent rester côté client.
IP protégées / cross-connect / VM routeur
Utile selon le niveau de simplification ou de maîtrise attendu.
Latence, MTU, routage asymétrique : ce que le handoff change vraiment
Le mode de retour impacte directement la latence perçue, le MTU disponible, le comportement en routage asymétrique et la facilité de diagnostic. Ce sont des sujets que les acheteurs techniques regardent de très près, surtout sur du gaming, des API ou des services critiques.
Un modèle de livraison crédible doit donc être pensé dès le départ avec les contraintes de prod : où le trafic revient, comment il ressort, quel MTU reste confortable, et comment éviter les surprises au moment où l’attaque arrive.
Pourquoi préserver l’existant est souvent la meilleure stratégie
Dans beaucoup de cas, le client ne veut pas réinventer son réseau. Il veut ajouter une couche anti-DDoS propre devant un dédié déjà en place, un cluster, un proxy métier ou une logique custom déjà rentable.
C’est pour cela que le retour propre du trafic compte autant. Il permet d’ajouter de la protection sans transformer l’intégration en migration lourde.
- Conserver un serveur existant chez OVH, Hetzner ou ailleurs
- Garder une logique XDP, DPDK ou proxy déjà en production
- Ajouter une couche de nettoyage sans déplacer toute l’architecture
- Monter en maturité progressivement plutôt que tout changer d’un coup
Erreurs fréquentes
La première erreur est de sous-estimer la relivraison et de se focaliser uniquement sur le “scrubbing”. La seconde est de choisir un mode de retour trop complexe alors qu’un montage plus simple aurait été plus robuste.
Une autre erreur courante consiste à ignorer les sujets de MTU, de supervision et de retour asymétrique, puis à découvrir les limites au pire moment, c’est-à-dire pendant l’attaque.
- Tout miser sur la mitigation
- Le nettoyage seul ne garantit pas un service réellement rétabli.
- Choisir le mode le plus “premium” par réflexe
- Le bon handoff est celui qui colle à la réalité de l’architecture cliente.
- Oublier les détails réseau
- MTU, retour, routage et monitoring ne sont jamais des détails pendant une crise.
FAQ
Le trafic propre peut-il revenir sur mon serveur actuel ?
Oui, dans beaucoup de cas c’est précisément le but du design.
GRE suffit-il souvent ?
Oui. Pour beaucoup de déploiements, un GRE simple est déjà un très bon compromis.
Quand faut-il ajouter du BGP ?
Surtout quand vous voulez conserver davantage de contrôle sur vos préfixes et votre routage.
Le handoff compte-t-il autant que la capacité affichée ?
Oui. Sans un bon retour propre, la capacité seule n’apporte pas le résultat attendu en production.
Pourquoi le trafic propre est-il souvent le vrai point faible ?
Parce que beaucoup de projets pensent d’abord au scrubbing puis improvisent la relivraison. Or une mauvaise remise du trafic propre casse vite la latence, les sessions ou l’exploitation.