Op deze pagina
Kernpunten
- Incident van aanval scheidenDDoS-detectie koppelt servicesymptomen aan netwerkbewijs.
- PPS, Gbps en fouten volgenie beperkt downtime en voorkomt paniekacties zoals servers rebooten, app-instellingen wijzigen of echte gebruikers…
- Mitigatie vroeg activerenMonitor Gbps, PPS, flows, bestemmingen, bronverdeling, protocolmix, SYN-rate, UDP-rate, pakketgroottes…
Definitie van het probleem
DDoS-detectie koppelt servicesymptomen aan netwerkbewijs. Eén metric is zelden genoeg: veel verkeer kan legitiem zijn, terwijl weinig bandbreedte met hoge PPS infrastructuur breekt.
Timing is belangrijk. Als het team pas na blackhole of totale uitval bevestigt, is beschikbaarheid al verloren.
DDoS-detectie is dus geen los tool, maar een proces van meten, interpreteren en handelen. Logs, Netflow, servermetrics en klantklachten moeten samen bekeken worden.
Waarom vroege detectie telt
Vroege detectie beperkt downtime en voorkomt paniekacties zoals servers rebooten, app-instellingen wijzigen of echte gebruikers blokkeren terwijl de aanval upstream doorgaat.
Voor hosting beschermt dit andere klanten. Voor gaming behoudt het vertrouwen. Voor bedrijven voorkomt het reputatie- en omzetimpact.
Vroege detectie helpt ook communicatie. Klanten accepteren een technisch incident beter wanneer duidelijk is welke laag geraakt wordt, welke maatregel loopt en welke data die keuze ondersteunt. Zonder zichtbaarheid voelt elke vertraging onzeker.
Wat je moet monitoren
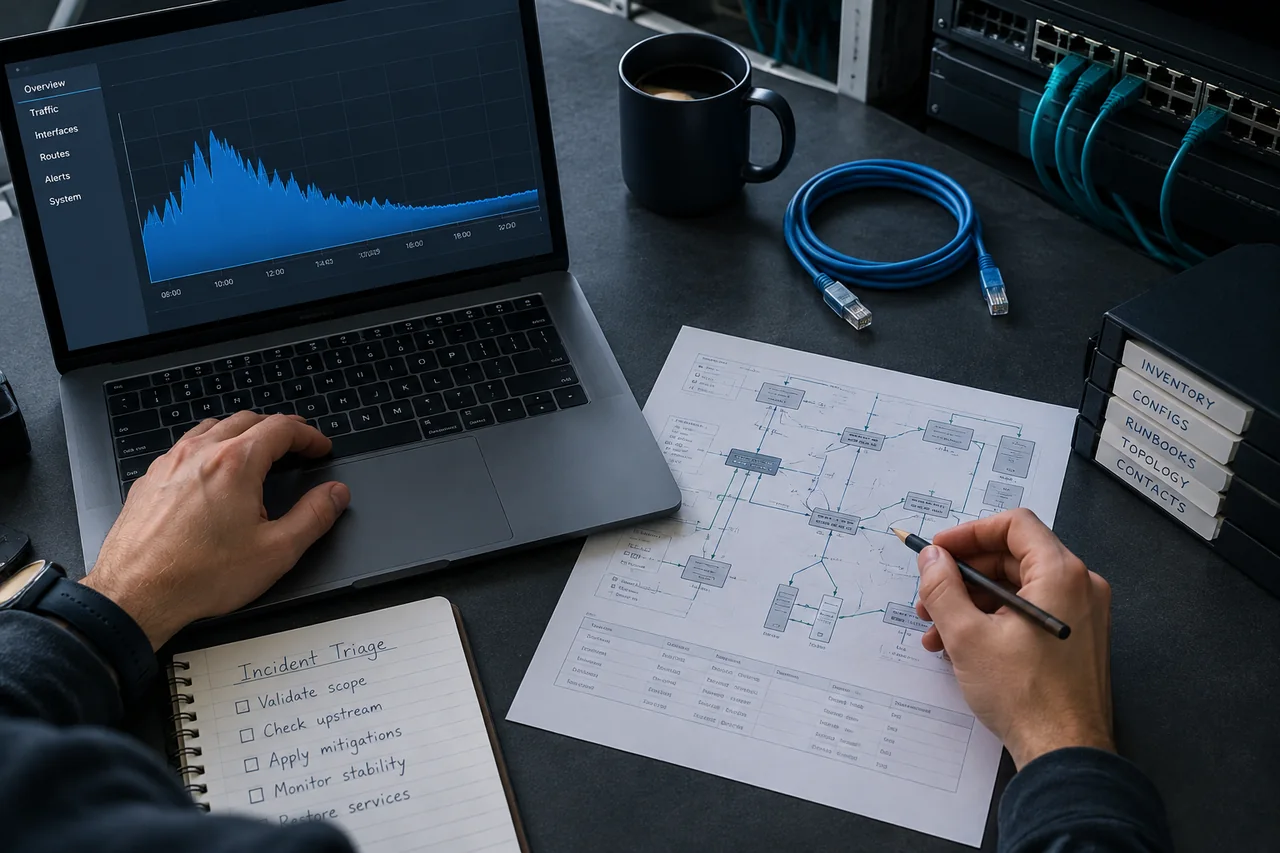
Monitor Gbps, PPS, flows, bestemmingen, bronverdeling, protocolmix, SYN-rate, UDP-rate, pakketgroottes, retransmits, mislukte handshakes en applicatiefouten.
Elke dienst vraagt eigen baselines. Web, DNS, Minecraft en FiveM hebben ander normaal gedrag; één alarmregel geeft valse positieven.
Een goed dashboard toont niet alleen gemiddelden, maar ook korte pieken. Veel DDoS-patronen werken in golven; wie alleen vijfminutengemiddelden ziet, vindt de oorzaak pas wanneer spelers of gebruikers al geraakt zijn.
Ook alarmmoeheid telt. Als elke piek een noodmelding geeft, negeren teams waarschuwingen. Beter zijn niveaus met duidelijke acties per ernst.
- DDoS-detectie vraagt correlatie tussen verkeer, applicatiefouten, PPS, verzadiging en gebruikersklachten.
Concreet voorbeeld
Een gamingcommunity ziet timeouts terwijl het serverproces draait. Matige Gbps, maar hoge PPS en herhaalde UDP-queries wijzen op flood in plaats van simpele app-bug.
Een B2B-platform ziet TLS-handshakefouten en hoge firewall-CPU. Het knelpunt ligt op de TCP-edge, niet in de webapp.
Voor providers moet detectie een actie starten: mitigatie openen, klant informeren, route wijzigen of support escaleren. Een grafiek zonder procedure verlaagt geen downtime.
Veelgemaakte fouten
Wachten op totale uitval is de grootste fout. Alleen bandbreedte bekijken en PPS, fouten en verlies negeren is ook gevaarlijk.
Niet elke piek is een aanval. Goede detectie vergelijkt met baselines, klantactiviteit, deployments en bekende monitoringevents.
Nog een fout is geen historie bewaren. Zonder vergelijking met normale dagen, campagnes, restarts of echte groei is aanval, bug en onderhoud lastig te scheiden.